
Surfer のグリッド化手法を理解する
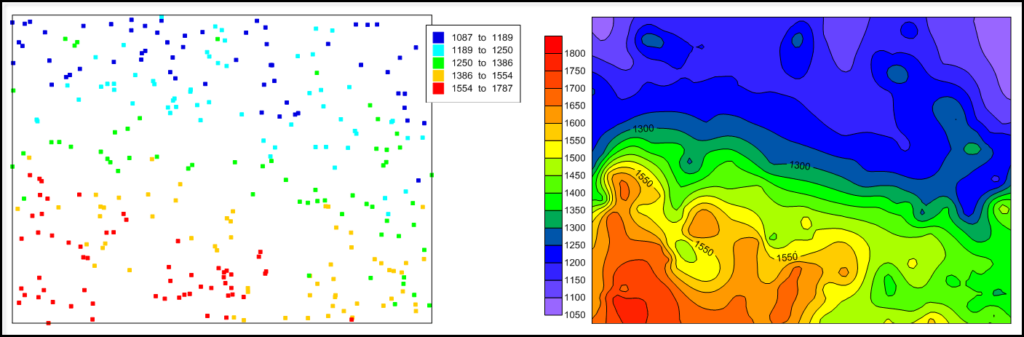
グリッド化(データ補間とも呼びます)とは、実世界で得られる散在したデータ点を、連続した等間隔のグリッドに変換する処理です。これは、2次元の散布図に近似曲線を当てはめることに似ています。近似曲線が X と Y のデータ点の傾向を線としてモデル化するのに対し、グリッド化はこの考え方を3次元に広げ、XYZ データには連続した面を、XYZC データには行列(3次元の格子)を当てはめます。
ちょうど、散布図の傾向を正確に表すために単純な直線か複雑な曲線かを選ぶのと同じように、面を作成するためのグリッド化手法も数多くあります。手法ごとに独自の数学的アルゴリズムを用います。標高図や温度分布図に見られるような、滑らかに連続する面を作るのに適した手法もあれば、地質学や環境解析の分野でよく見られる、鋭い境界や急激な変化を保つのに適した手法もあります。
適切なグリッド化手法を選ぶことは、データ解析で最も重要な工程の一つです。選んだ手法は、最終的なマップの見た目と、何より精度を直接左右します。不適切な手法を選ぶと、曲線的なデータを直線でモデル化するのと同じように結果がゆがみ、データを誤って解釈することにつながります。この記事では、Surfer で使えるグリッド化手法を解説します。目的に最も合った手法を選び、できる限り正確で意味のあるマップを作成するための参考にしてください。
データに最適なグリッド化手法をテストで見極める具体的な方法については、記事「Surfer で適切なグリッド化手法を選ぶ」を参照してください。
- クリギング法(Kriging)
- 最近傍法(Nearest Neighbor)
- 自然近傍法(Natural Neighbor)
- 局所多項式法(Local Polynomial)
- 動径基底関数法(Radial Basis Function)
- 線形補間による三角形分割法(Triangulation with Linear Interpolation)
- データメトリクス(Data Metrics)
1. クリギング法(Kriging)
クリギング法は、柔軟性と精度に優れたグリッド化手法の一つで、そのため最もよく推奨される手法です。クリギング法が有効なのは、ほとんどのデータセットでよいマップが得られることに加え、データが一部に集中している(クラスター状の)場合でも、集中している部分の重みを予測全体の中で小さくし、点が多い場所に推定が引きずられるのを防げるからです。短所としては、ほかの手法より処理が遅くなることがあり、特に大きなデータセットでは顕著になります。また、入力データの Z 値の範囲を超えて、グリッドの Z 値を外挿することがよくあります。
クリギング法の仕組み
各グリッドノードの値は、そのノードの近くにある既知のデータ点をもとに求めます。各データ点には、ノードからの距離に応じた重みが付けられます。こうすることで、ノードから遠い点ほど、ノードの推定に与える影響(重み)が小さくなります。たとえば、グリッドノード A の Z 値を計算するには、次の式を使います。
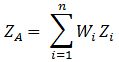
ここで ZA はグリッドノード A の推定値、n は推定に使う近傍のデータの数、Zi は位置 i における値で、Wi はその重みです。重みの合計が 1 になるようにして、偏在したデータ点に推定が偏らないようにします。ドリフト(drifts)や探索半径(search radius)などを適用すると、式はより複雑になります。〔訳注:ドリフトは、データ全体に見られるゆるやかな傾向(トレンド)のことです。Surfer のクリギング法では、ドリフトを「なし」「線形」「2次」から選べます。ドリフトを指定すると、その傾向を推定式に組み込んで計算します(ユニバーサルクリギング)。探索半径は、グリッドノードの推定に使うデータ点を探す範囲の大きさです。この範囲の外にある点は推定に使われません。〕
Surfer でクリギング法を使ってグリッド化する
Surfer のクリギング法のデフォルトの設定は、ドリフトなしのポイントクリギングと円形の探索楕円です。特に指定しない限り、このデフォルトの設定が使われます。
- Home | Wizards | Create Grid をクリックします。(※Surfer 31 以前は Home | Grid Data | Grid Data)
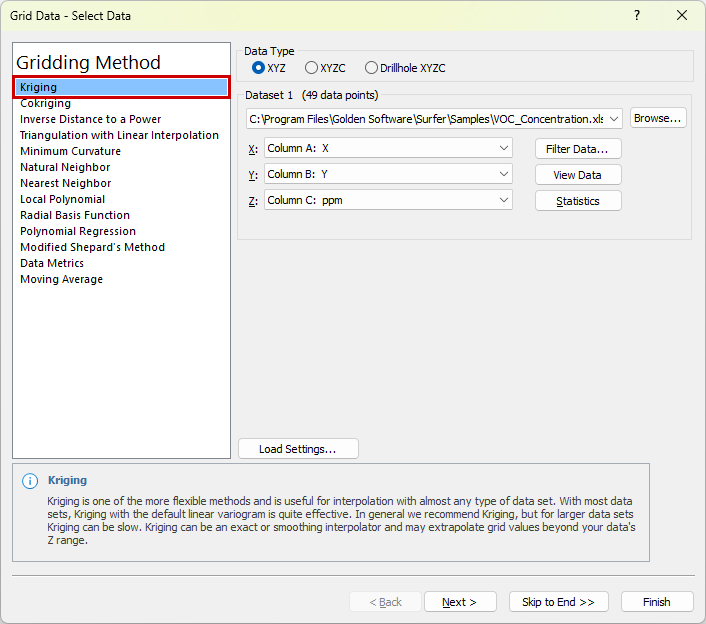
- Grid Data – Select Data ダイアログで、Gridding Method を Kriging に変更します。
- Browse をクリックして、Dataset(データファイル)を選びます。
- X、Y、Z の列を指定し、Next ボタンをクリックして、バリオグラムモデルの選択に進みます。
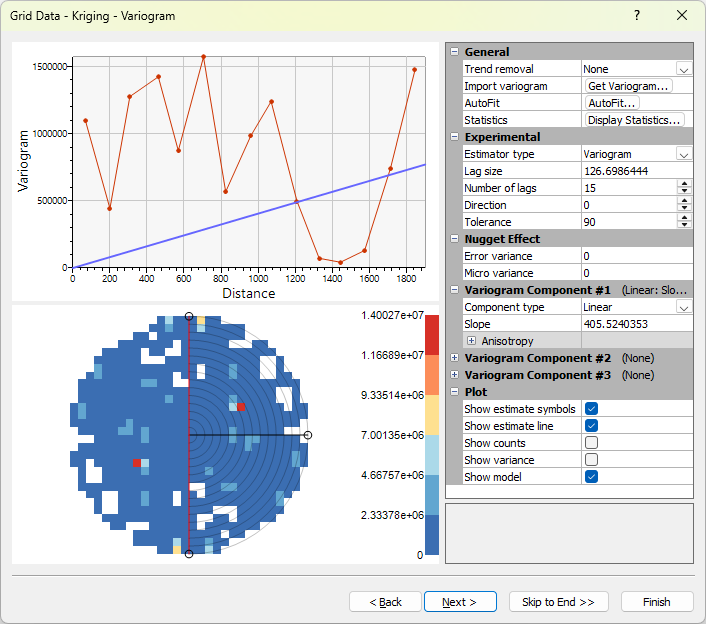
- Grid Data – Kriging – Variogram ダイアログには、データに適したバリオグラムモデルを選ぶのに必要な設定がすべてそろっています。
バリオグラムは、面の粗さを定量的・統計的に記述するものです。バリオグラムは、2つの位置 x と y の値のばらつきの度合いを表します。このセクションは、クリギング法で作成するバリオグラムに成分を追加するのに使います。たとえば、バリオグラムにナゲット(nugget)を追加できます。ナゲットは、距離を 0 に近づけてもセミバリオグラムが 0 まで下がらずに残る値を表します。どの成分を追加すべきか分からない場合は、ナゲット効果なしのデフォルトの線形(Linear)バリオグラムを使うのが最善です。バリオグラムについて詳しくは、記事「Surfer のクリギングにおけるバリオグラムのモデル化 ── チュートリアル」を参照してください。 - Next ボタンをクリックして、クリギング法のオプションの設定に進みます。
- Grid Data – Kriging – Options ダイアログには、専用の設定項目を含む3つのセクションがあります。各セクションの詳細は、Surfer のヘルプを参照してください。
- Kriging Parameters(クリギングのパラメーター)
- Search Neighborhood(探索近傍)
- Breaklines(ブレークライン)
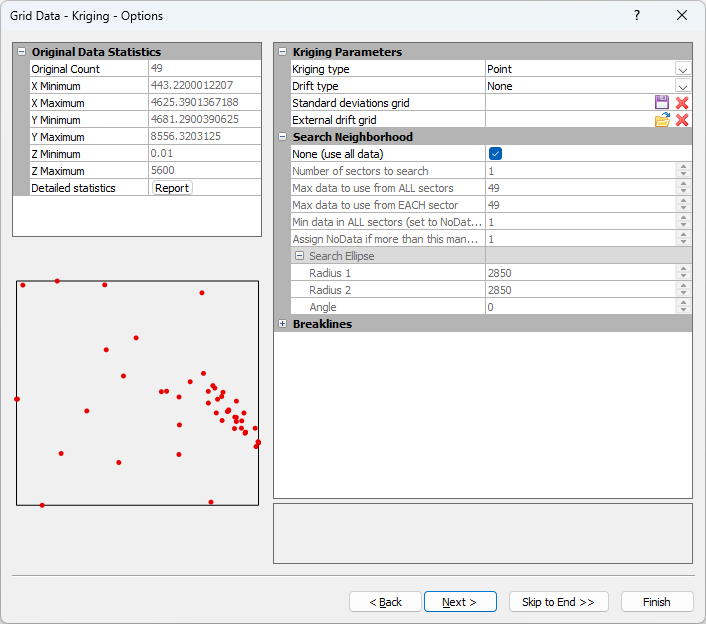
- Next をクリックして、交差検証(クロスバリデーション)のレポートを表示します。
- Next をクリックして、出力グリッドのオプションを表示します。
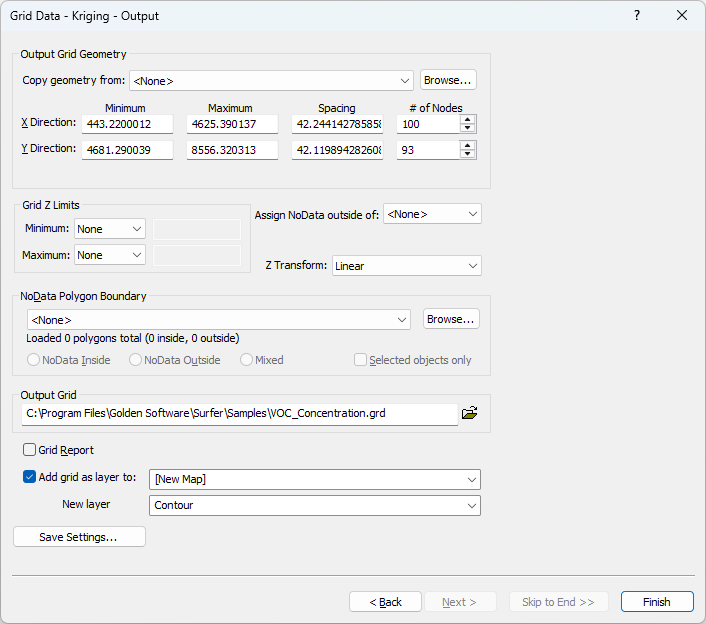
- Grid Data – Kriging – Output ダイアログで、次のようにします。
- X Direction と Y Direction の Spacing または # of Nodes を調整して、出力グリッドの解像度を上げます。
- Assign NoData outside of のオプションを使うか、NoData Polygon Boundary を定義して、特定の範囲に null 値(NoData 値)を割り当てます。
- Output Grid 欄で、ファイル名、形式、保存場所を指定します。
- Add grid as layer to 欄と New layer 欄で、グリッドファイルをどこに、どのように表示するかを選びます。
- Finish をクリックして、グリッドファイルを作成します。
2. 最近傍法(Nearest Neighbor)
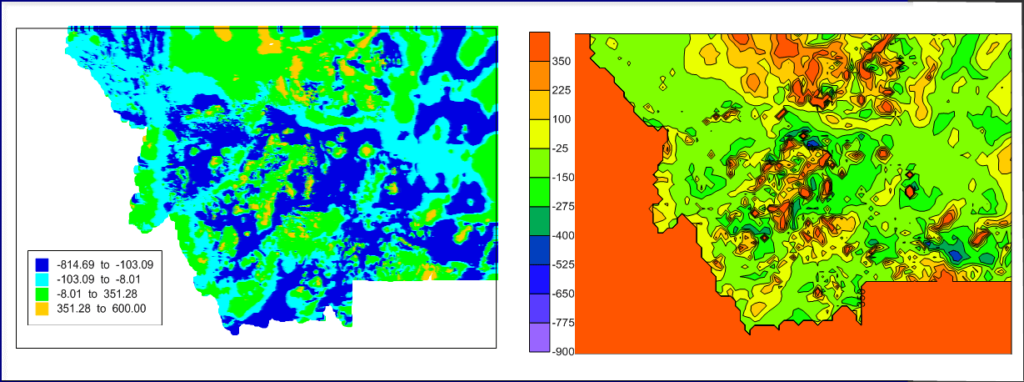
最近傍法は、規則的な間隔で並んだデータ点に使うのが最適です。観測データにいくつか欠測がある場合、その穴を埋めるにはこの手法が最適です。この手法は厳密な補間法(exact interpolator)で、データの Z 値の範囲を超えて外挿することはありません。
最近傍法の仕組み
最近傍法は、数学的に複雑な手法ではありません。最近傍法では、各グリッドノードの Z 値は、そのノードに最も近い元のデータ点の Z 値そのものになります。グリッドノードの最近傍は、異方性を考慮しない単純な距離で決まります。最近傍となる点が2つ以上ある(距離が等しい)場合は、それらの点を X、Y、Z の値の順に並べ替え、最も小さい値の点を最近傍として選びます。
Surfer での最近傍法のオプション
グリッド化手法を最近傍法にするには、Grid Data – Select Data ダイアログで Gridding Method を Nearest Neighbor に変更し、Dataset を選び、X、Y、Z の列を指定します。最近傍法の設定を変更するには、Next ボタンをクリックして Grid Data – Nearest Neighbor – Options ダイアログを開きます。
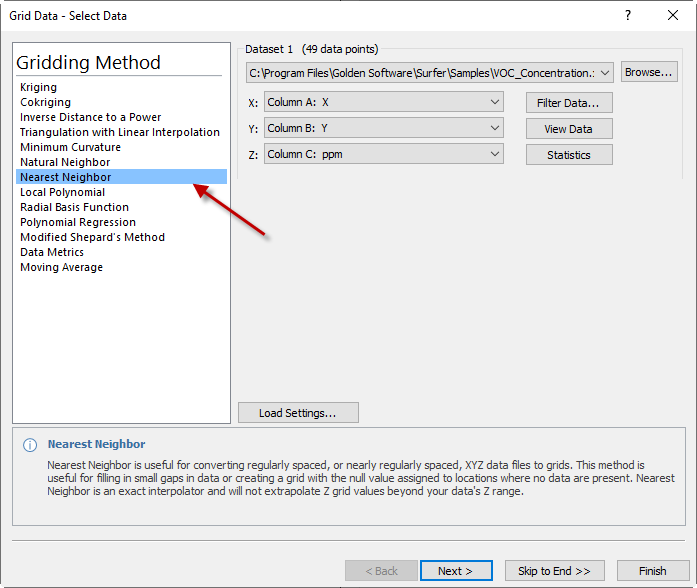
Search セクションでは、探索楕円の半径と角度を指定します。
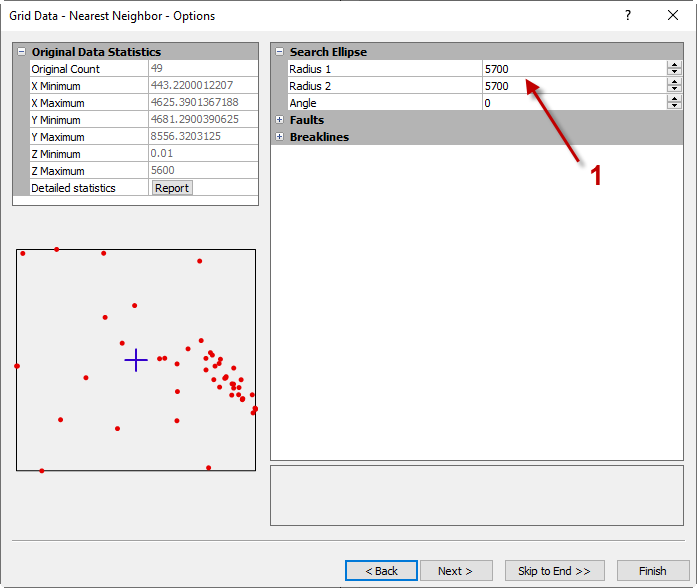
- 探索楕円は、データを探す局所的な近傍の大きさを指定するもので、設定した探索ルールの影響を受けることがあります。Radius 1 と Radius 2 の値は、データの単位で表した正の距離です。半径の値は、角度(Angle)で示す方向に探索する長さです。角度は、正の X 軸と楕円の Radius 1 の軸とのなす向きで表します。探索楕円の中に点が1つも見つからない場合、そのグリッドノードには NoData 値が割り当てられます。デフォルトでは探索楕円は円形で、グリッドノードの周囲のどの方向にも同じ重みが与えられます。デフォルトの長さは、データの範囲の対角線の長さです。
探索オプションを調整して、データ点のない広い範囲に NoData 値を割り当てることもできます。そのためには、探索楕円の半径を、データ間の距離より小さい値に設定します。
Breaklines and Faults セクションでは、グリッド化に使うブレークラインと断層の境界ファイルを指定します。
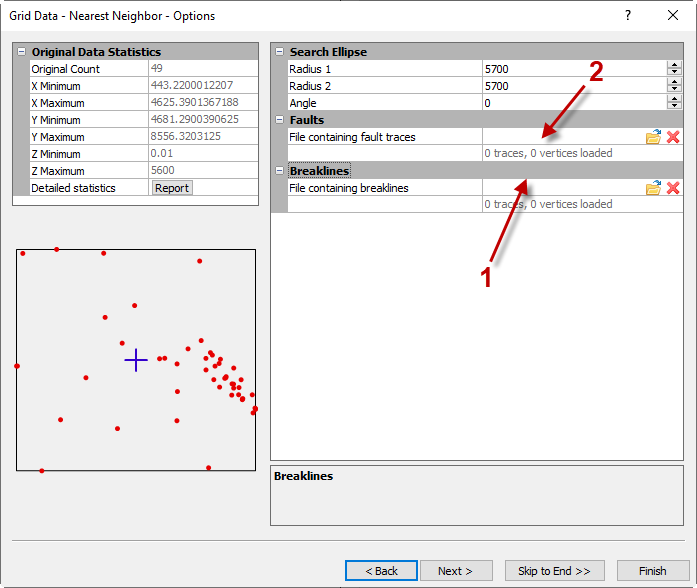
- ブレークラインは、急な崖が平らな地面に変わる境目のように、面の傾斜が急に変わる位置を表す線です。自然の地形では、波打った不規則な線になることも多くあります。マップ上の不規則な部分や不連続を表すのに役立ちます。ブレークラインはグリッド化の際の障壁にはなりません。つまり、グリッドノードを補間するときには、線のどちら側にあるかにかかわらず、線の両側のデータ点がすべて使われます。ただし、グリッドノードが境界線上にある場合、そのグリッドノードの値は境界ファイルの値になります。
ブレークラインファイルには、途切れの位置の X、Y、Z の頂点が空白化ファイル(*.BLN)形式で格納されます。1行目がファイル内のデータ点の数で、その後に線の XYZ 座標が続きます。 - 断層は、データをグリッド化するときに障壁としてはたらく2次元の線です。断層線は、地殻の運動によって割れ目に沿って生じた大きな不連続を表します。グリッド化では、断層線が情報の障壁となり、断層の片側のデータは、反対側の値を補間するときには使われません。
断層ファイルには、断層を表す線の X、Y の値が空白化ファイル(*.BLN)形式で格納されます。1行目がファイル内のデータ点の数で、その後に線の XY 座標が続きます。
3. 自然近傍法(Natural Neighbor)
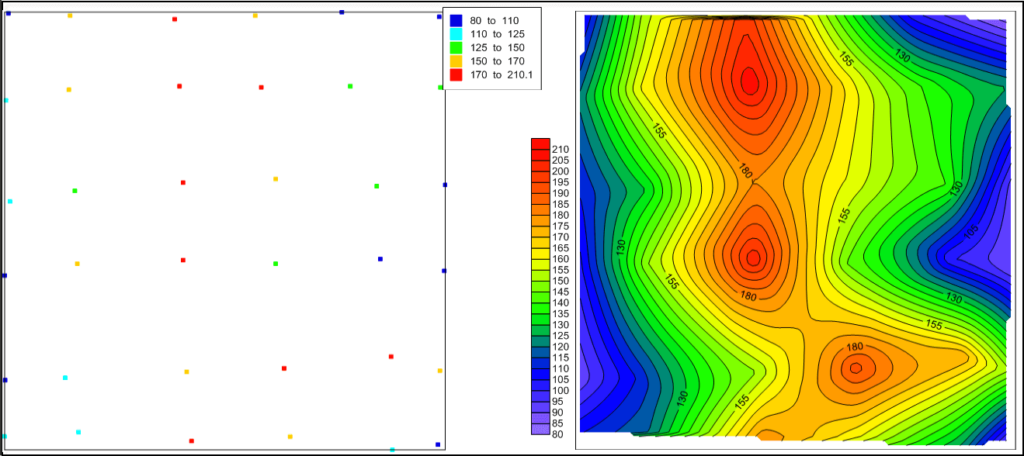
自然近傍法は、データが密な領域と疎な領域が混在するデータセットでよく使われます。自然近傍法は、グリッドノードに最も近い入力データ点の部分集合を見つけ、それぞれに重みを付けてグリッドノードの値を推定します。自然近傍法は、データの範囲を超えてグリッドの Z 値を外挿することはなく、データのない領域にはノード(値)を生成しません。
Surfer での自然近傍法のオプション
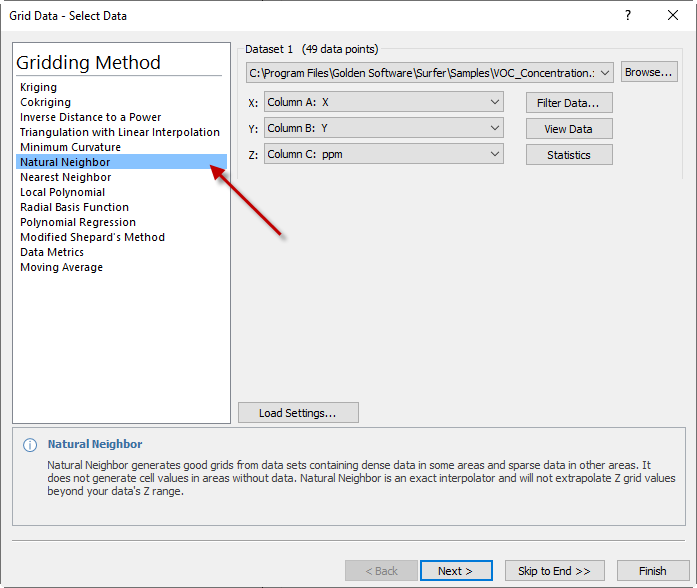
自然近傍法には、異方性(anisotropy)を設定するオプションと、ドロネー三角形(Delaunay triangles)を保存するオプションがあります。自然近傍法の詳細オプションを指定するには、Grid Data – Select Data ダイアログで Next ボタンをクリックします。
異方性は、グリッドノードを補間するときにデータのトレンドを取り除くのに役立ちます。異方性とは、データの性質が方向によって異なることをいいます。Grid Data Advanced Options ダイアログでは、グリッド化について3つの項目を設定できます。設定できる項目は次のとおりです。
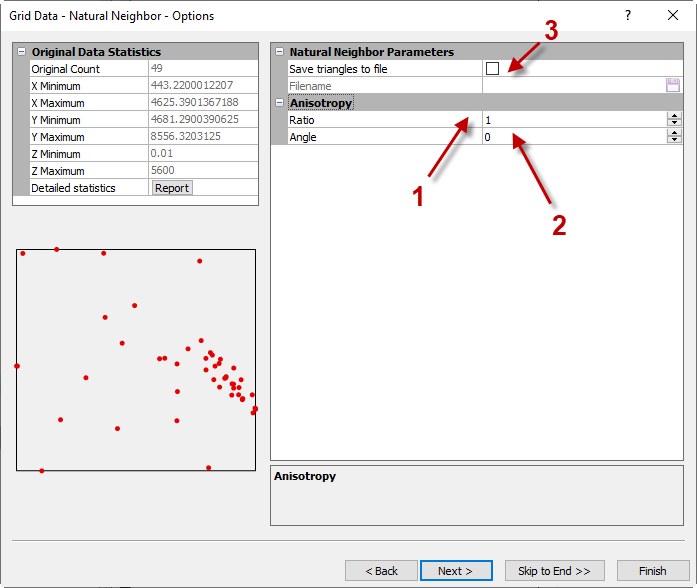
- Anisotropy Ratio(異方性比):グリッドノードを補間するときの点の相対的な重みを決める値です。最大レンジを最小レンジで割って求めます。ほとんどのデータセットでは、デフォルト値の 1 をそのまま使うことをお勧めします。1 は、すべての点の重みが同じであることを意味します。ある方向の点どうしが、別の方向の点どうしよりも似ている場合は、比を大きくするとよいでしょう。比を大きくすると、指定した方向の点が、補間するグリッドノードの値により大きく影響します。一般に、比が 4 を超えると強い異方性、2 未満なら弱い異方性とみなされます。
- Anisotropy Angle(異方性角度):主軸の方向を度単位で表した角度です。角度は反時計回りに測り、0 度が東西方向、90 度が南北方向です。角度による方向の指定を有効にするには、異方性比を 1 以外にする必要があります。
- Save Triangles To(三角形の保存先):ドロネー三角形は、データ点どうしを線で結んで作られます。多くの場合、三角形は最小の内角が最大になるように作られるため、小さな三角形ができにくくなります。その結果、グリッド全体が三角形の面で覆われます。すべての点が同一直線上にある場合、ドロネー三角形分割はできません。作られた三角形どうしが交差することはありません。三角形は、データ点の密度を把握するのに役立ちます。ドロネー三角形はベースマップとして読み込み、ほかのマップと組み合わせることができます。ファイルを保存するには、フォルダーのアイコンをクリックし、保存先とファイル形式を指定します。
4. 局所多項式法(Local Polynomial)
局所多項式法は、探索近傍の範囲内で比較的滑らかなデータセットに最も適しています。この手法は、定めた近傍の中の点を使って、指定した次数の多項式を当てはめます。多項式の次数によって、データへの当てはめ方が変わります。たとえば、1次の多項式はデータに平面を当てはめ、2次は1回反った面(お椀形や山形)を、3次は2回うねった面(断面がS字形)を当てはめる、というようになります。グリッド化する面が、傾斜と平坦の繰り返しのように複数の形をもつ場合は、複数の多項式の面を使うのが最善です。複数の多項式の面を使うと、面をより正確に表せます。計算速度がデータセットの大きさに左右されないため、この手法は大きなデータセットにも向いています。
多項式は、重み付き最小二乗法でデータに当てはめます。各グリッドノードには、そのノードでの多項式の値が割り当てられます。Surfer では、多項式の次数を 1、2、3 から選べます。グリッドノードに近いデータほど、遠いデータより大きな重みをもちます。
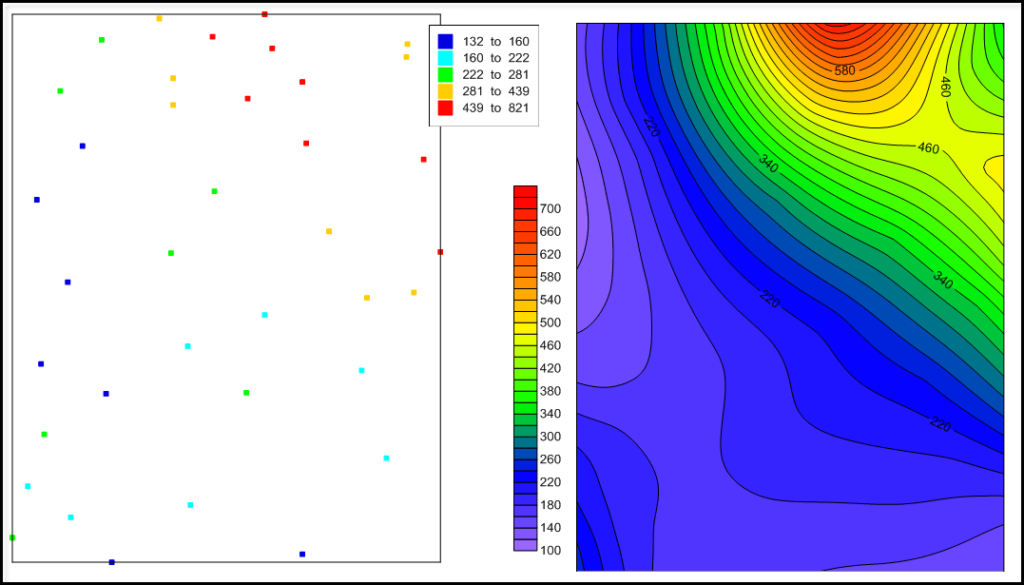
次の例は、局所多項式法でグリッド化したデータセットです。
Surfer での局所多項式法のオプション
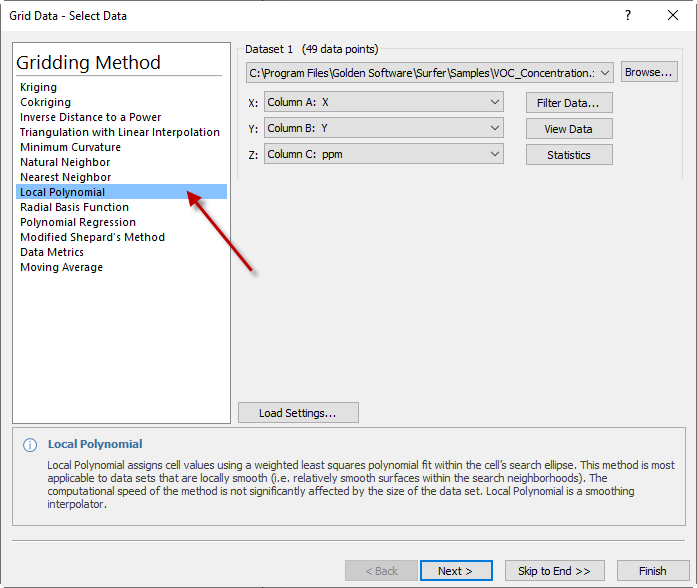
局所多項式法の詳細オプションを指定するには、Grid Data ダイアログで Advanced Options をクリックします。
Grid Data – Local Polynomial Options の Local Polynomial Parameters セクションには、Power と Polynomial Order の設定があります。
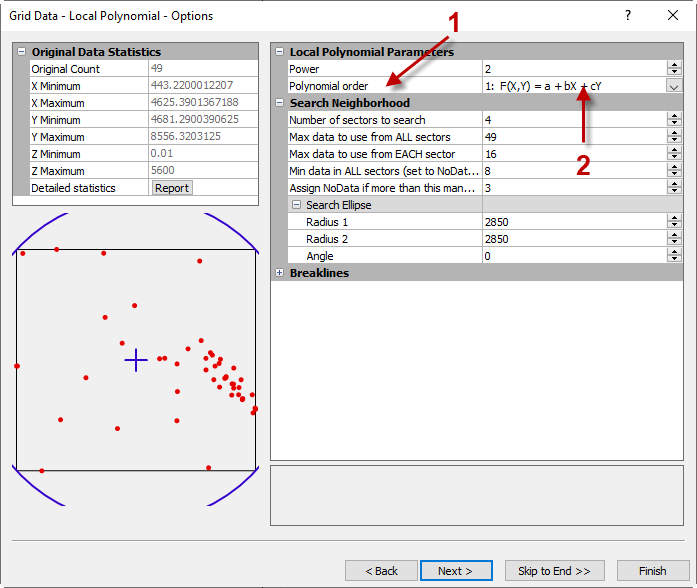
- Power(べき指数):指定したべき指数は、残差の2乗和を最小にするための重みの計算に適用されます。0〜20 の値を設定します。
- Polynomial Order(多項式の次数):データの補間に使う多項式の次数を選びます。
Search Neighborhood セクションでは、グリッドノードを補間するときに考慮する点(探索オプション)を指定します。
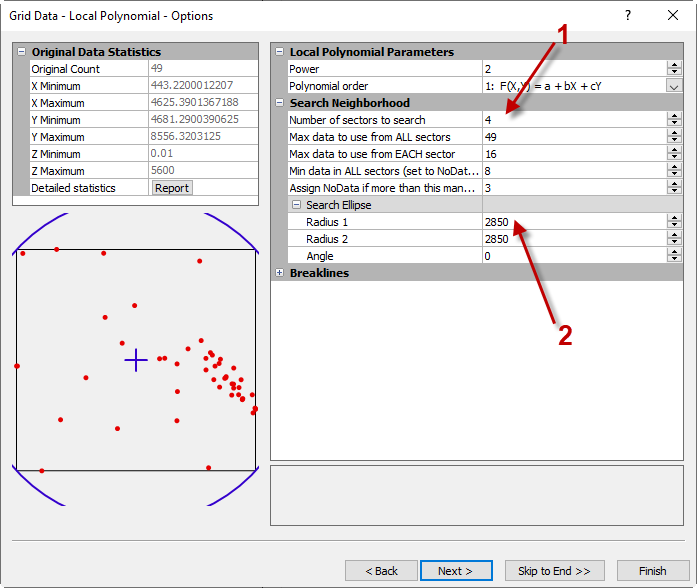
- Search options(探索オプション):Search Neighborhood で設定したオプションによって、Surfer はグリッドノードの補間にどのデータ点を使うかを判断します。データセットの大きさなど、データセットの種類に応じて探索の設定を変えると効果的な場合があります。
- Number of sectors to search(探索するセクター数):探索範囲を複数のセクターに分割します。最大 32 セクターまで指定できます。偏在した(クラスター状の)データに最適です。
- Maximum number of data to use for ALL sectors:推定全体に使う点の総数の上限です。
- Maximum number of data to use from EACH sector:各セクターから使う点の数の上限です。
- Minimum number of data in all sectors (node is set to NoData if fewer):グリッドノードの推定時に十分な数の点が見つからない場合、Surfer はそのグリッドノードに NoData 値を割り当てます。NoData 値のグリッドノードはデータが不足していることを表し、マップ上の等高線はそこで途切れます。
- Assign NoData to node if more than this many sectors are empty:グリッドノードに対して(データのある)セクターが足りない場合、Surfer はそのグリッドノードに NoData 値を割り当てます。
- Search Ellipse(探索楕円):探索楕円は、データを探す局所的な近傍の大きさを指定するもので、設定した探索ルールの影響を受けることがあります。Radius 1 と Radius 2 の値は、データの単位で表した正の距離です。半径の値は、角度(Angle)で示す方向に探索する長さです。角度は、正の X 軸と楕円の Radius 1 の軸とのなす向きで表します。探索楕円の中に点が1つも見つからない場合、そのグリッドノードには NoData 値が割り当てられます。デフォルトでは探索楕円は円形で、グリッドノードの周囲のどの方向にも同じ重みが与えられます。デフォルトの長さは、データの範囲の対角線の長さの半分です。
探索オプションを調整して、データ点のない広い範囲に NoData 値を割り当てることもできます。そのためには、探索楕円の半径を、データ間の距離より小さい値に設定します。
Breaklines セクションでは、グリッド化に使うブレークラインの境界ファイルを指定します。
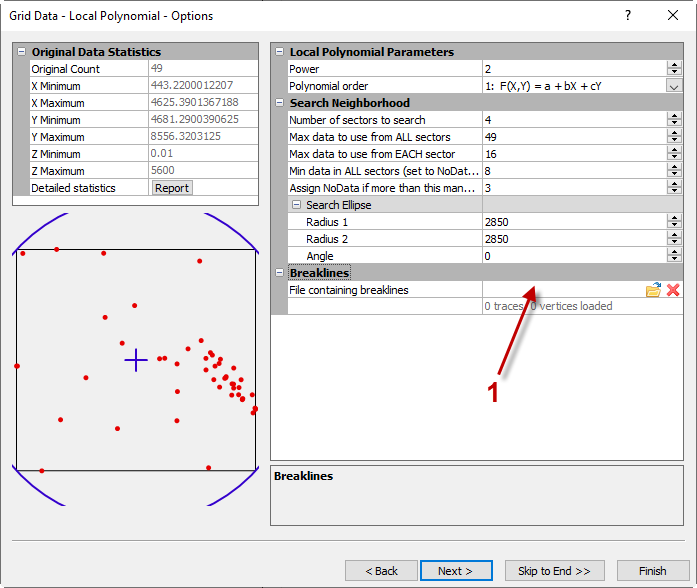
- ブレークラインは、急な崖が平らな地面に変わる境目のように、面の傾斜が急に変わる位置を表す線です。自然の地形では、波打った不規則な線になることも多くあります。マップ上の不規則な部分や不連続を表すのに役立ちます。ブレークラインはグリッド化の際の障壁にはなりません。つまり、グリッドノードを補間するときには、線のどちら側にあるかにかかわらず、線の両側のデータ点がすべて使われます。ただし、グリッドノードが境界線上にある場合、そのグリッドノードの値は境界ファイルの値になります。
ブレークラインファイルには、途切れの位置の X、Y、Z の頂点が空白化ファイル(*.BLN)形式で格納されます。1行目がファイル内のデータ点の数で、その後に線の XYZ 座標が続きます。
5. 動径基底関数法(Radial Basis Function)
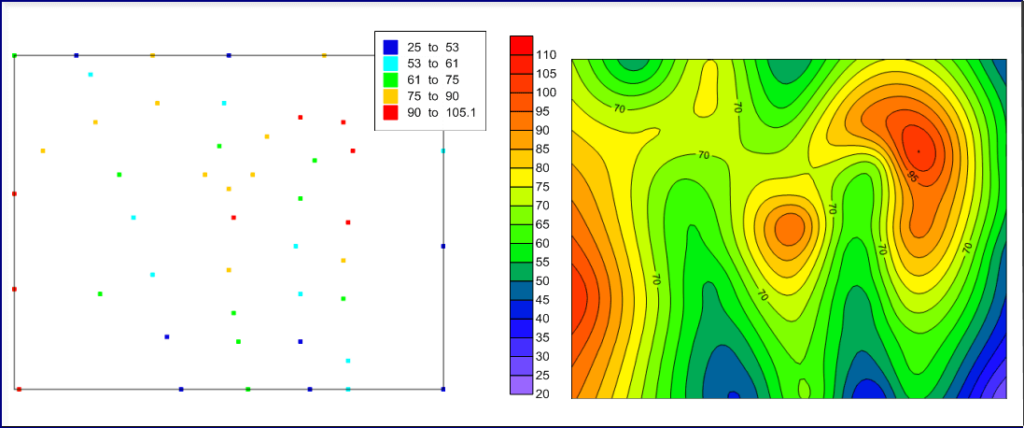
動径基底関数法は厳密な補間法です。つまり、データの値を変えずに、それを通る面を作ります。この手法で使う基底関数は、中心となる点(各データ点)からの距離だけで値が決まる関数(real-value function)です。この手法は、柔軟でほとんどのデータセットを精度よく表せるという点で、クリギング法に似ています。大きなデータセットも扱え、滑らかな面を作成できます。ただし、短い距離の間で面の値が大きく変わるデータには、あまり適していません。動径基底関数法は、ユーザーが指定した関数をデータ値に当てはめます。
次の例は、動径基底関数法でグリッド化したデータセットです。
Surfer での動径基底関数法のオプション
動径基底関数法の詳細オプションを指定するには、Grid Data – Select Data ダイアログで Next ボタンをクリックします。
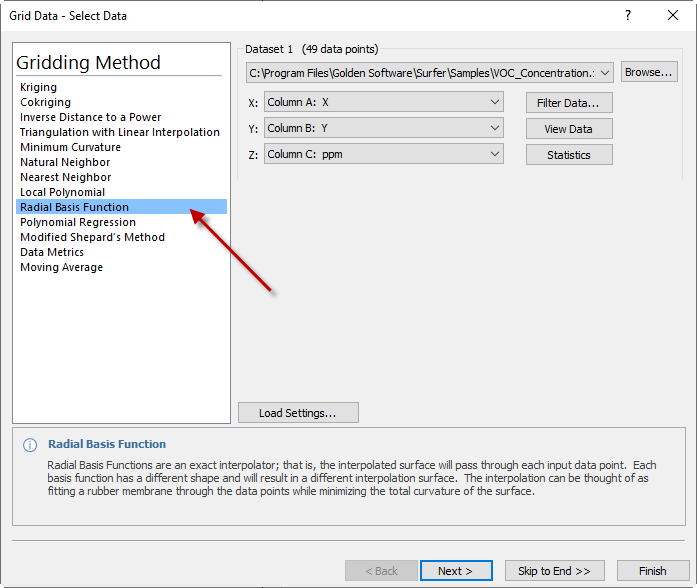
Radial Basis Parameters セクションでは、Basis Function と R2 Parameter を指定します。
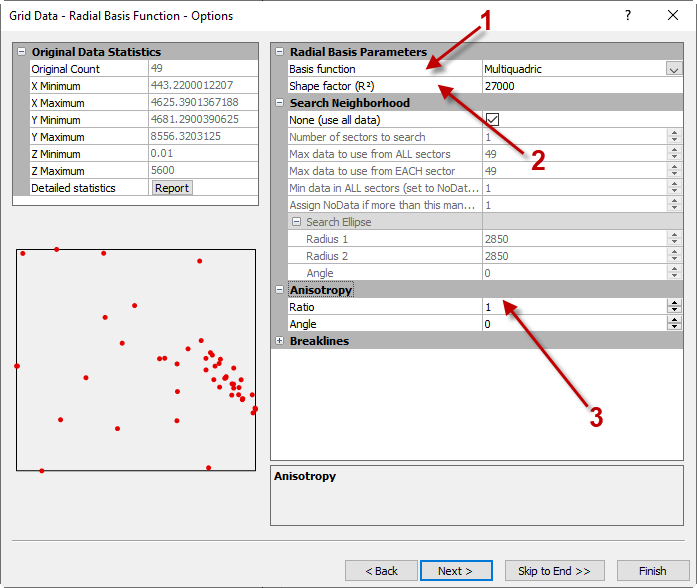
- Basis Function(基底関数):基底とする関数を指定します。選んだ関数によって、グリッドノードを補間するときにデータ点に与える最適な重みの組が決まります。各関数の式は次のとおりです。
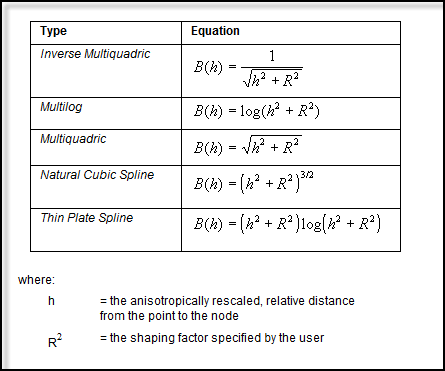
上の式は、このグリッド化手法の Basis Function として選べる関数です。
- R2 Parameter:R2 は形状係数(shaping factor)と呼ばれます。R2 の値を大きくすると、等高線が滑らかで、山頂が丸みを帯びたマップになります。値は次の式で計算されます。
(データ範囲の対角線の長さ)2 / (25 × データ点の数)
R2 にどの値を入力しても、動径基底関数法は厳密な補間法です。 - Anisotropy Ratio(異方性比):グリッドノードを補間するときの点の相対的な重みを決める値です。最大レンジを最小レンジで割って求めます。ほとんどのデータセットでは、デフォルト値の 1 をそのまま使うことをお勧めします。1 は、すべての点の重みが同じであることを意味します。ある方向の点どうしが、別の方向の点どうしよりも似ている場合は、比を大きくするとよいでしょう。比を大きくすると、指定した方向の点が、補間するグリッドノードの値により大きく影響します。一般に、比が 4 を超えると強い異方性、2 未満なら弱い異方性とみなされます。
Anisotropy Angle(異方性角度):主軸の方向を度単位で表した角度です。角度は反時計回りに測り、0 度が東西方向、90 度が南北方向です。角度による方向の指定を有効にするには、異方性比を 1 以外にする必要があります。
Search Neighborhood セクションでは、グリッドノードを補間するときに考慮する点(探索オプション)を指定します。
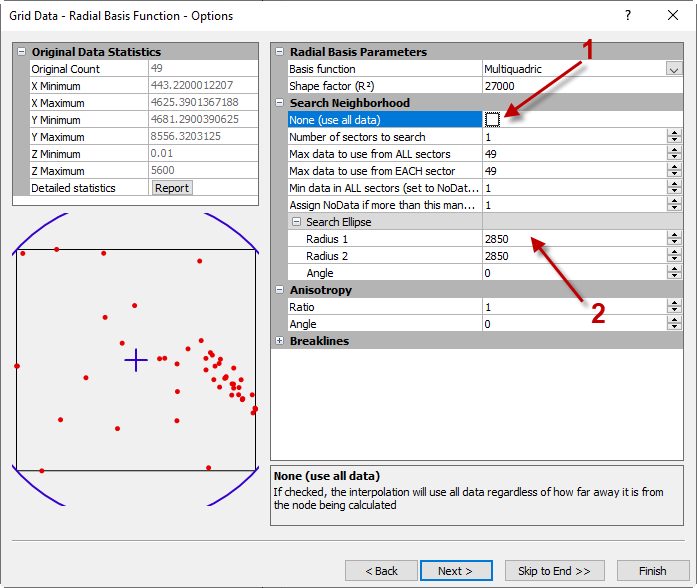
- Search options(探索オプション):Search タブで設定したオプションによって、Surfer はグリッドノードの補間にどのデータ点を使うかを判断します。データセットの大きさなど、データセットの種類に応じて探索の設定を変えると効果的な場合があります。たとえば、データセットが小さい(データ点が 250 未満の)場合は、No Search オプションを使い、すべてのデータでグリッドノードを補間するのが妥当です。逆に、データセットが大きい場合は、各グリッドノードの補間に使うデータ点の数を制限するのがよいでしょう。
- No Search(探索しない):このオプションを選ぶと、Surfer はグリッドファイルの推定にすべてのデータ点を使います。250 点程度までの小さなデータセットに向いています。均等に分布したデータにも適しています。このオプションが無効(選択不可)になっている場合は、データ点が 750 を超えているため、ファイルをより小さいセクターに分けないとグリッド化できないことを示しています。
- Number of sectors to search(探索するセクター数):探索範囲を複数のセクターに分割します。最大 32 セクターまで指定できます。偏在した(クラスター状の)データに最適です。
- Maximum number of data to use for ALL sectors:推定全体に使う点の総数の上限です。
- Maximum number of data to use from EACH sector:各セクターから使う点の数の上限です。
- Minimum number of data in all sectors (node is set to NoData if fewer):グリッドノードの推定時に十分な数の点が見つからない場合、Surfer はそのグリッドノードに NoData 値を割り当てます。NoData 値のグリッドノードはデータが不足していることを表し、マップ上の等高線はそこで途切れます。
- Assign NoData to node if more than this many sectors are empty:グリッドノードに対して(データのある)セクターが足りない場合、Surfer はそのグリッドノードに NoData 値を割り当てます。
- Search Ellipse(探索楕円):探索楕円は、データを探す局所的な近傍の大きさを指定するもので、設定した探索ルールの影響を受けることがあります。Radius 1 と Radius 2 の値は、データの単位で表した正の距離です。半径の値は、角度(Angle)で示す方向に探索する長さです。角度は、正の X 軸と楕円の Radius 1 の軸とのなす向きで表します。探索楕円の中に点が1つも見つからない場合、そのグリッドノードには NoData 値が割り当てられます。デフォルトでは探索楕円は円形で、グリッドノードの周囲のどの方向にも同じ重みが与えられます。デフォルトの長さは、データの範囲の対角線の長さの半分です。
探索オプションを調整して、データ点のない広い範囲に NoData 値を割り当てることもできます。そのためには、探索楕円の半径を、データ間の距離より小さい値に設定します。
Breaklines セクションでは、グリッド化に使うブレークラインの境界ファイルを指定します。
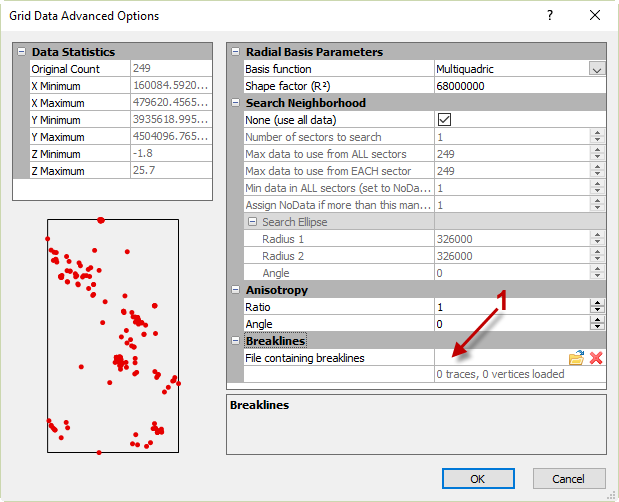
Breaklines セクションでは、ブレークラインの情報を含む空白化ファイルを読み込みます。
- ブレークラインは、急な崖が平らな地面に変わる境目のように、面の傾斜が急に変わる位置を表す線です。自然の地形では、波打った不規則な線になることも多くあります。マップ上の不規則な部分や不連続を表すのに役立ちます。ブレークラインはグリッド化の際の障壁にはなりません。つまり、グリッドノードを補間するときには、線のどちら側にあるかにかかわらず、線の両側のデータ点がすべて使われます。ただし、グリッドノードが境界線上にある場合、そのグリッドノードの値は境界ファイルの値になります。
ブレークラインファイルには、途切れの位置の X、Y、Z の頂点が空白化ファイル(*.BLN)形式で格納されます。1行目がファイル内のデータ点の数で、その後に線の XYZ 座標が続きます。
6. 線形補間による三角形分割法(Triangulation with Linear Interpolation)
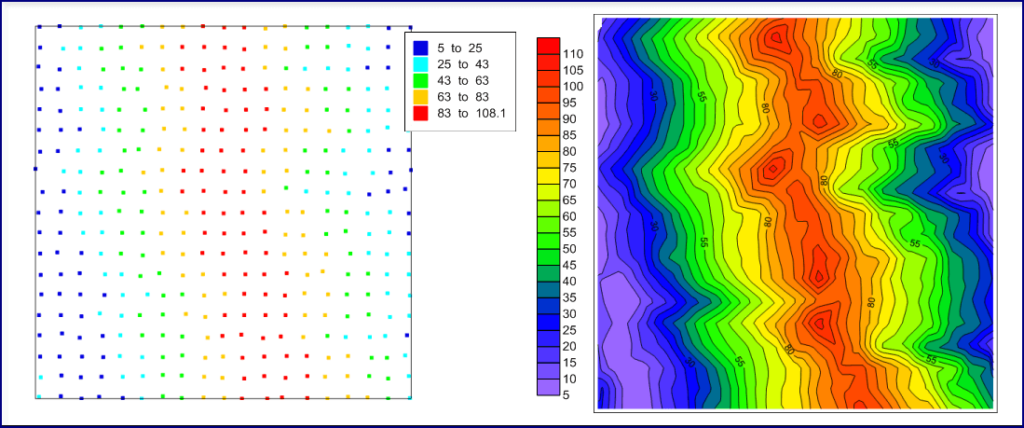
線形補間による三角形分割法は、グリッドの範囲全体に均等に分布したデータに最も適しています。マップが三角形の平らな面をつなぎ合わせたような見た目になる場合は、データセットが小さすぎるか、データが疎な領域を含んでいる可能性が高いといえます。この手法は、データ点どうしを線で結んで三角形を作ります。三角形の辺がほかの三角形と交差することはありません。処理が速く、データの Z 値の範囲を超えて外挿することもありません。さらに、データの範囲外にデータを作り出すことはなく、データの範囲外にあるグリッドノードには NoData 値を割り当てます。
次の例は、線形補間による三角形分割法でグリッド化したデータセットです。
Surfer での線形補間による三角形分割法のオプション
線形補間による三角形分割法の詳細オプションを指定するには、Grid Data – Select Data ダイアログで Next ボタンをクリックします。
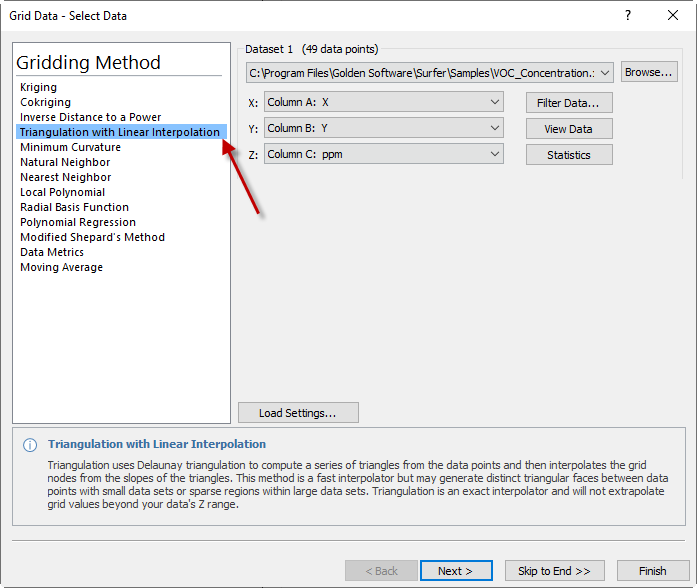
異方性は、グリッドノードを補間するときにデータのトレンドを取り除くのに役立ちます。異方性とは、データの性質が方向によって異なることをいいます。Grid Data Advanced Options ダイアログでは、グリッド化について3つの項目を設定できます。設定できる項目は次のとおりです。
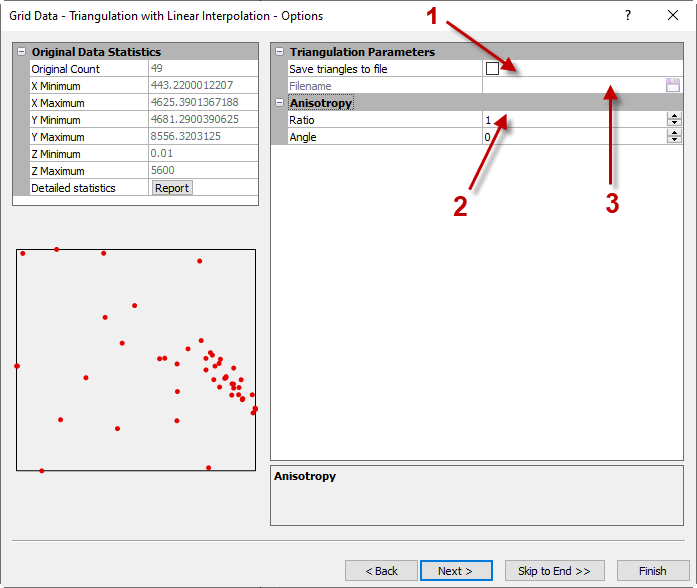
- Anisotropy Ratio(異方性比):グリッドノードを補間するときの点の相対的な重みを決める値です。最大レンジを最小レンジで割って求めます。ほとんどのデータセットでは、デフォルト値の 1 をそのまま使うことをお勧めします。1 は、すべての点の重みが同じであることを意味します。ある方向の点どうしが、別の方向の点どうしよりも似ている場合は、比を大きくするとよいでしょう。比を大きくすると、指定した方向の点が、補間するグリッドノードの値により大きく影響します。一般に、比が 4 を超えると強い異方性、2 未満なら弱い異方性とみなされます。
- Anisotropy Angle(異方性角度):主軸の方向を度単位で表した角度です。角度は反時計回りに測り、0 度が東西方向、90 度が南北方向です。角度による方向の指定を有効にするには、異方性比を 1 以外にする必要があります。
- Save Triangles To(三角形の保存先):ドロネー三角形は、データ点どうしを線で結んで作られます。多くの場合、三角形は最小の内角が最大になるように作られるため、小さな三角形ができにくくなります。その結果、グリッド全体が三角形の面で覆われます。すべての点が同一直線上にある場合、ドロネー三角形分割はできません。作られた三角形どうしが交差することはありません。三角形は、データ点の密度を把握するのに役立ちます。ドロネー三角形はベースマップとして読み込み、ほかのマップと組み合わせることができます。ファイルを保存するには、フォルダーのアイコンをクリックし、保存先とファイル形式を指定します。
7. データメトリクス(Data Metrics)
データメトリクスは、データセットの統計的なパラメーターをマップに表すのに使えるグリッド化手法です。グリッド化手法の一つではありますが、データを補間して Z 値を求めるわけではない点で、ほとんどの手法と異なります。データメトリクスは、データ点についての情報をグリッドの形で得るために使います。グリッド線の配置、探索、ブレークライン、断層のパラメーターなどは、ほかの手法でグリッド化するときと同じ設定にすることをお勧めします。
データメトリクスには、Z Order Statistics(Z の順序統計量)、Z Moment Statistics(Z のモーメント統計量)、Other Z Statistics(その他の Z 統計量)、Data Location Statistics(データ位置の統計量)、Terrain Statistics(地形の統計量)の5つの主なグループがあります。各グループは、データのどの側面を分析するかで分類されています。各統計パラメーターについて、データは計算を行う探索範囲に分けられ、計算結果がその範囲のグリッドノードに割り当てられます。データメトリクスでは、探索パラメーターごとに範囲の大きさと対象のノードを指定できます。この手法は、データについて特定の情報を計算し、その計算結果からマップを作成したい場合に役立ちます。